Mesuré en production réelle, pas sur une démo.
Un chiffre ne vaut que par sa méthode : quels champs, quels documents, quelle part de validation humaine. Nous publions tout cela, et nous rejouons la même méthode sur vos propres documents pendant le pilote, avant tout engagement.
La méthode de mesure, champ par champ →
Toute la chaîne documentaire du transport.
Le moteur reconnaît 36 types de documents transport, regroupés en 14 familles — livraison, transport, commande, préparation, expédition, enlèvement, facturation, réception, retour, logistique — et extrait sur chacun le type, le numéro, la date et l’émetteur. Sur le bon de livraison, l’extraction est complète : destinataire et contenu ligne à ligne. Pour tout autre document — CMR, ordre de transport, preuve de livraison, ou un document propre à votre métier — le modèle est affiné sur vos exemplaires pendant le pilote, jusqu’à l’extraction complète.
Le document sur lequel le moteur est mesuré : 195 000 exemplaires réels traités en production, 2 365 mises en page.
Reconnue, numérotée et datée d’emblée ; cases, réserves manuscrites et tampons extraits en totalité après affinage sur vos CMR.
Reçu par e-mail, PDF ou tableur : identifié et daté d’emblée ; après affinage sur vos ordres, il devient une commande dans votre TMS sans ressaisie.
Reconnue et rattachée à l’ordre ; signature, date et réserves extraites après affinage, pour que la preuve parte vers la facturation le jour même.
Contrôlée ligne à ligne contre l’ordre et la grille tarifaire ; seuls les écarts remontent.
Les documents amont et aval de la même chaîne, pour un rapprochement complet commande ↔ livraison ↔ facture.
Pas du texte brut : des données.
Un OCR classique rend des caractères. Le moteur rend des champs nommés, normalisés et rapprochés de vos référentiels, prêts à entrer dans le TMS.
D’emblée, sans configuration.
Le destinataire, rapproché de vos sites, et le contenu ligne à ligne — références, quantités, unités, poids, lots, colis.
Quel que soit le format d’écriture, normalisée.
Fournisseur, transporteur ou expéditeur — identifié même quand l’en-tête change.
Site, entrepôt ou client livré.
BL, CMR, ordre, POD, facture : classé automatiquement dans le flux.
Et les numéros associés : commande, ordre de transport, référence client.
Références, désignations, quantités, unités, poids, lots, colis — sous forme de tableau structuré.
{
  "type": "bon_de_livraison",
  "numero": "BL-2026-04871",
  "date": "2026-09-09",
  "emetteur": { "nom": "…", "siren": "…" },
  "destinataire": { "site": "Entrepôt Perpignan" },
  "commande_ref": "CMD-77120",
  "lignes": [
    { "ref": "MV-310", "designation": "Carottes sable — sac 10 kg", "qte": 60, "unite": "sacs", "poids_kg": 600.0 }
  ],
  "confiance": { "date": 0.99, "emetteur": 0.98, "destinataire": 0.97, "numero": 0.96 },
  "etat": "AUTO",
  "a_valider": []
}
Document → données, extraction réelle.
Quatre bons de livraison fictifs — sociétés, adresses et références inventées, aucune donnée client — passés dans le moteur de production le 12 septembre 2026. À gauche le document, à droite ce qui en sort, avec les champs envoyés en validation surlignés.
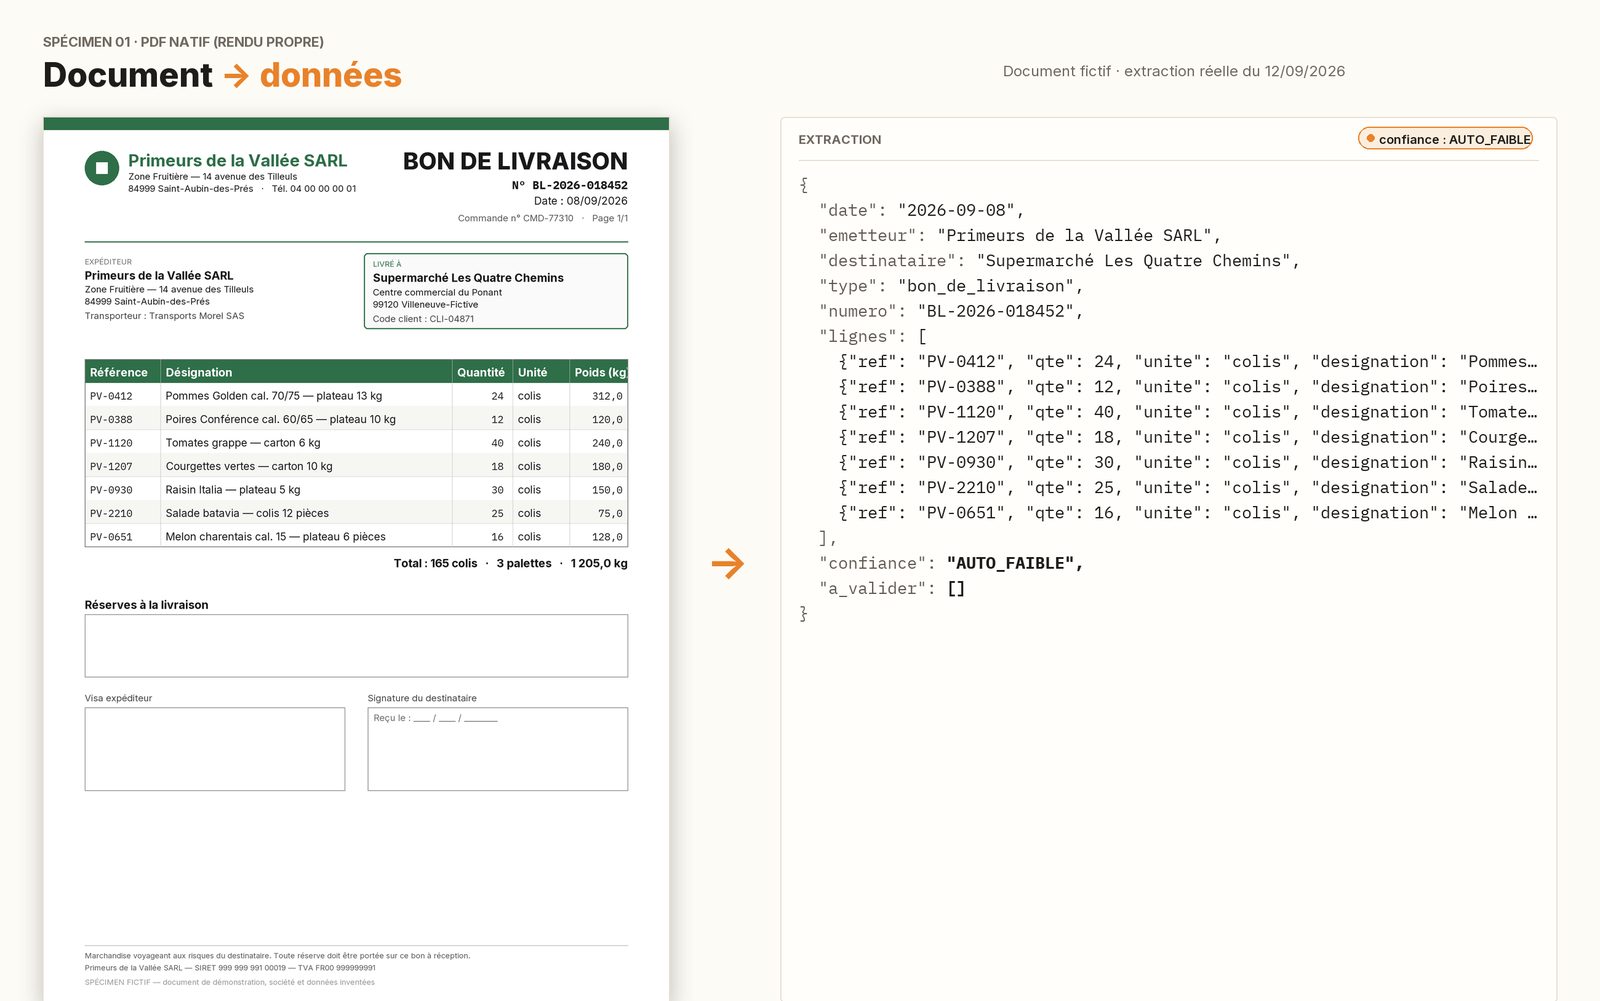
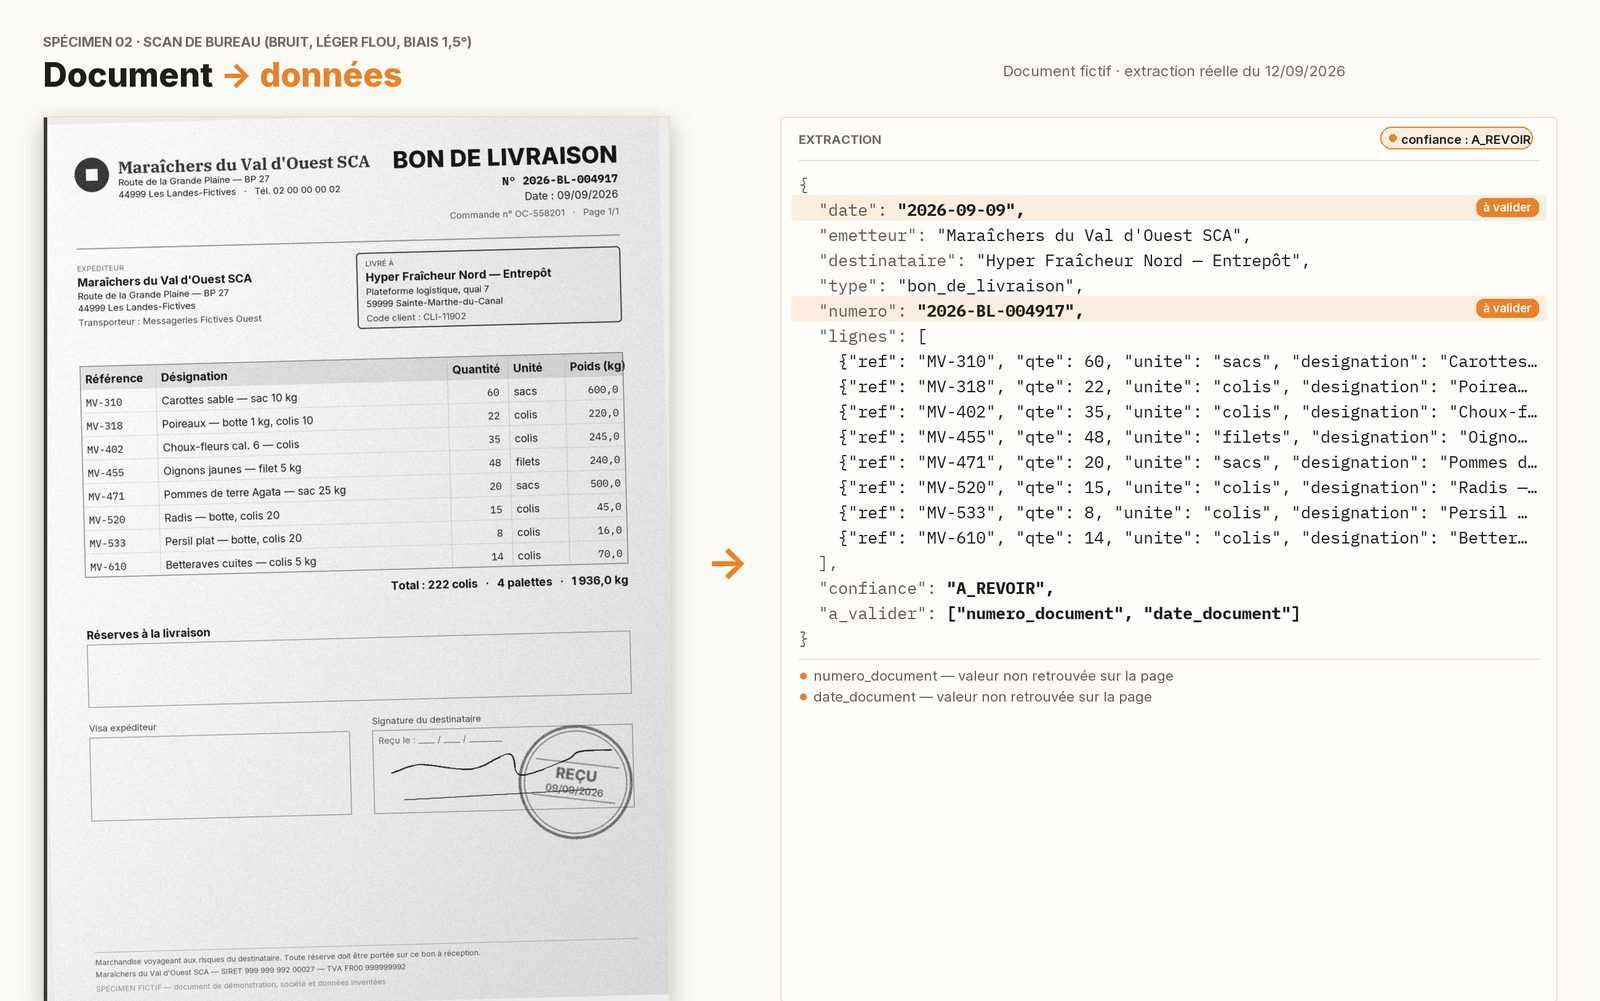
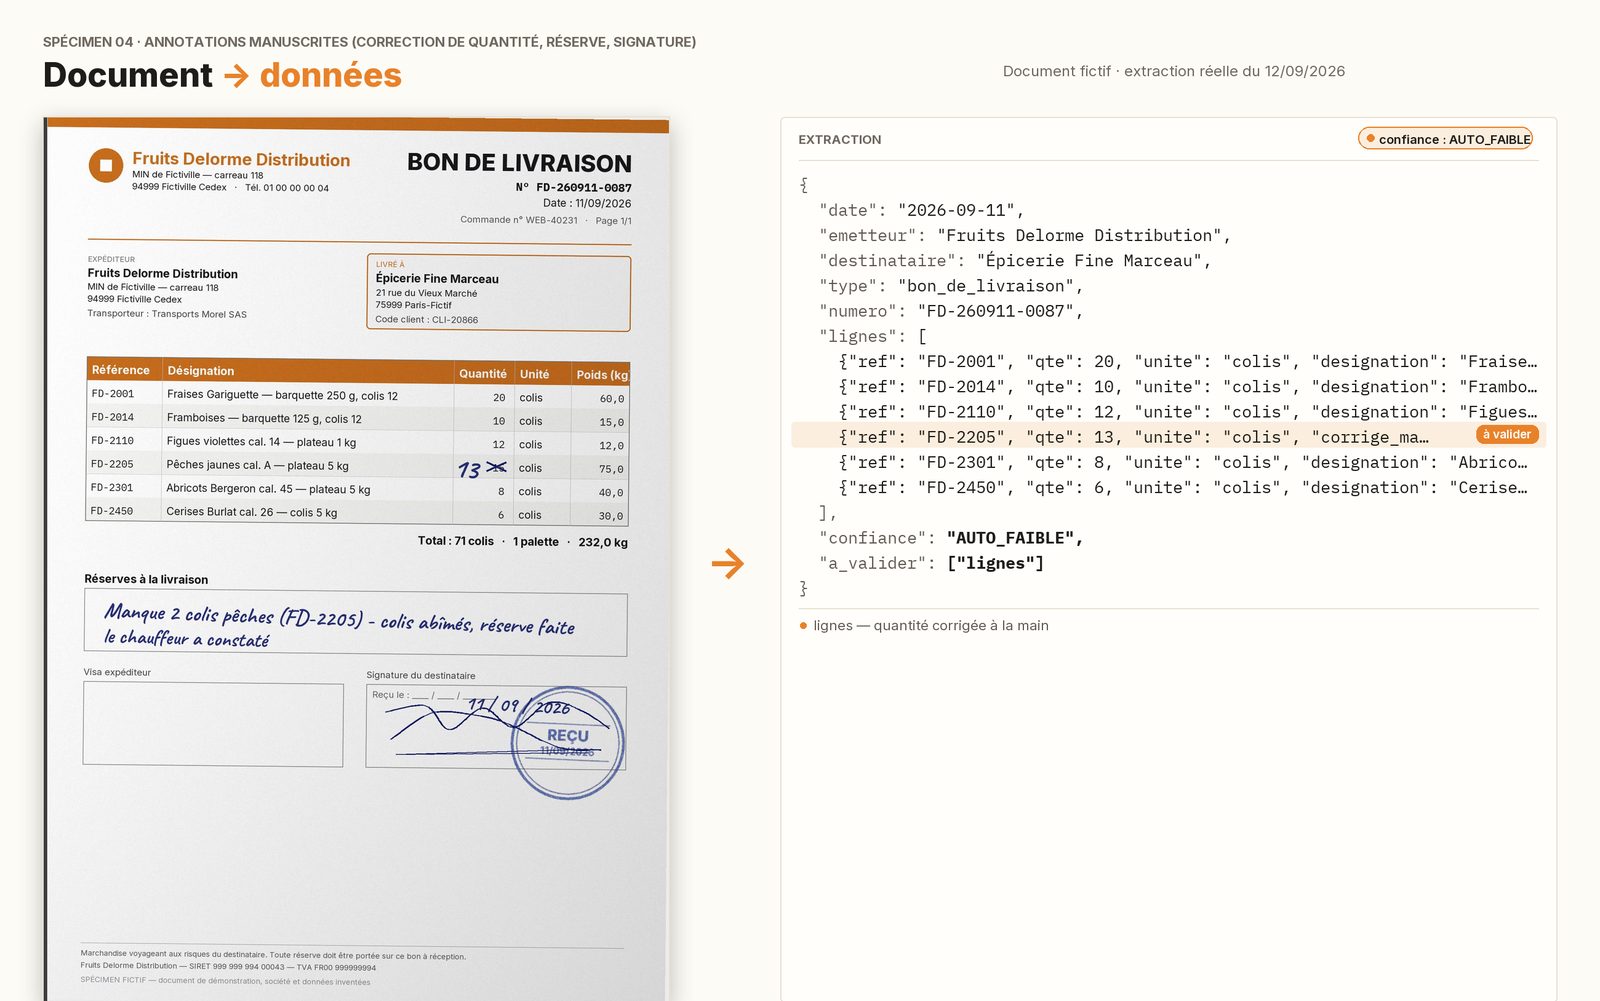
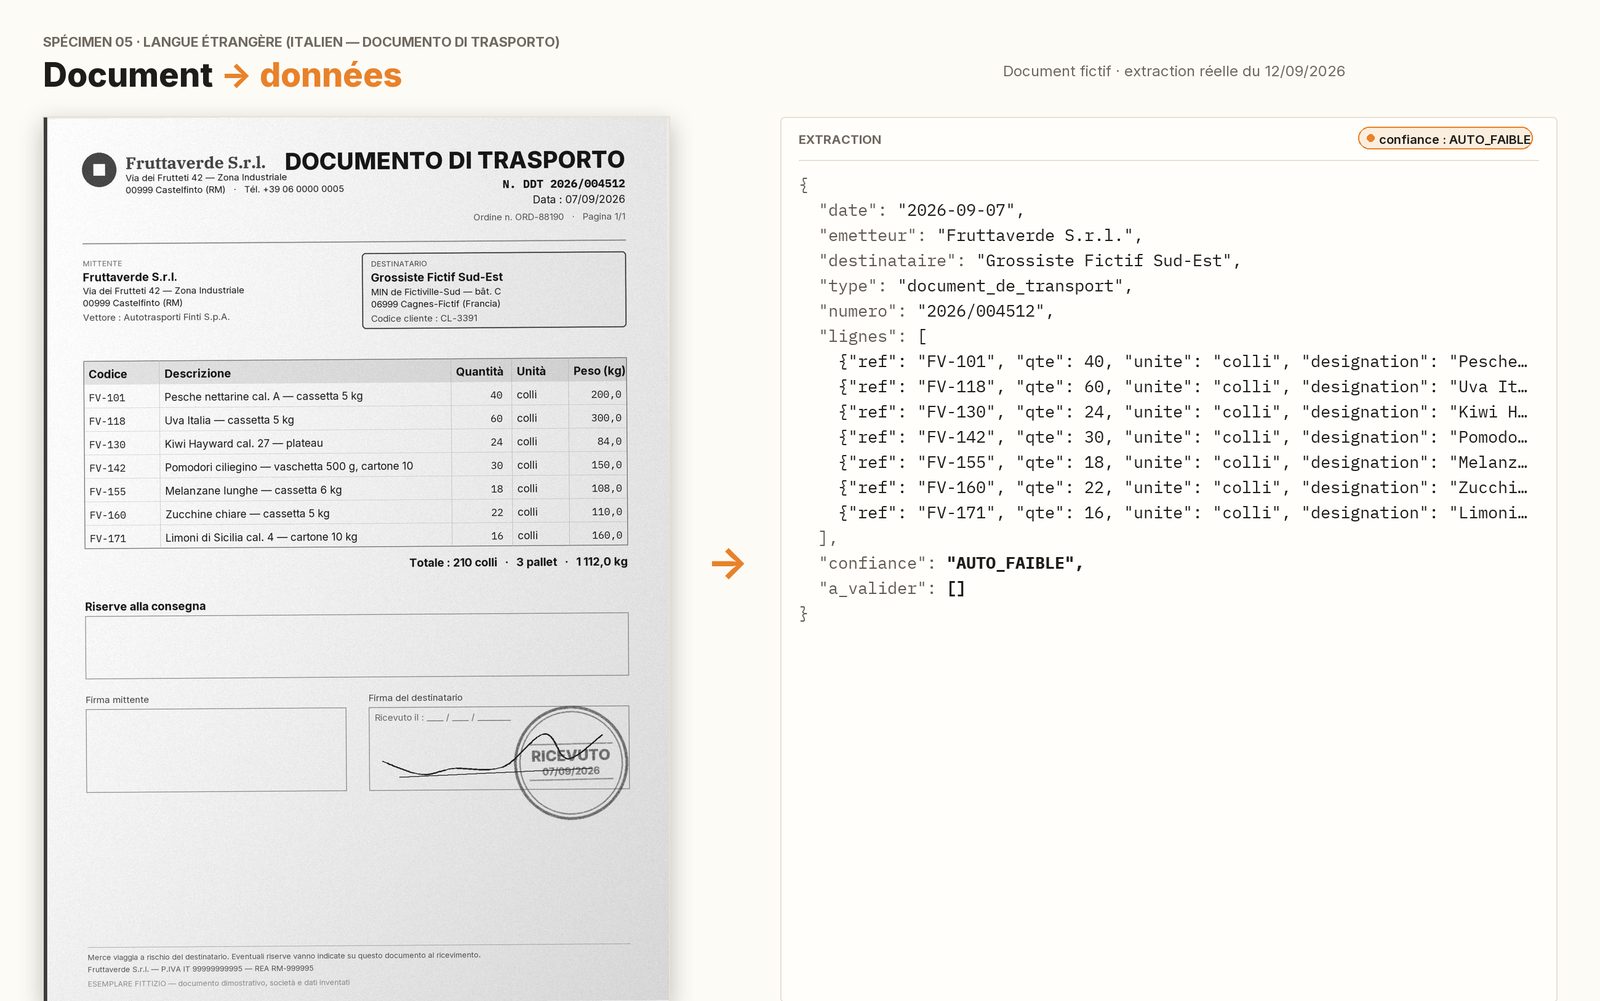
Spécimens synthétiques ; reconnaissance et lecture des champs par les services de production. Aucun document réel n’est publié.
OCR pour lire, raisonnement pour comprendre.
Deux étages : un OCR robuste aux scans et aux photos, puis un modèle de langage spécialisé qui interprète le document comme le ferait un exploitant — quel émetteur, quelle commande, quelles lignes, quelle réserve. C’est ce second étage, entraîné sur des millions de documents transport, qui fait la différence avec un OCR à gabarits.
- 01Capture
PDF déposé par API, dans un dossier surveillé, une bibliothèque SharePoint ou par e-mail : le document entre par le canal que vous utilisez déjà.
- 02Lecture
Le document est redressé, l’OCR lit le texte, y compris scanné ; le modèle spécialisé comprend ce que chaque zone signifie — pas seulement les caractères.
- 03Structuration
Les champs sont extraits, normalisés et rapprochés de vos référentiels : fournisseurs, articles, commandes ouvertes.
- 04Contrôle
Chaque champ porte un niveau de confiance. Ce qui est certain passe ; ce qui ne l’est pas est surligné pour une personne.
- 05Écriture
Les données validées sont écrites dans votre TMS, votre ERP ou exportées (JSON, CSV, API, webhook). Le document est archivé avec son extraction.
Principe non négociable : l’IA ne devine jamais en silence. Chaque champ porte un niveau de confiance ; en dessous du seuil, une personne tranche, et sa correction sert à affiner le modèle sur vos formats.
Chaque correction de vos équipes en vaut deux cents.
Le moteur ne se contente pas de lire : il apprend de l’exploitant. Quand une personne valide ou corrige un champ, ce verdict est mémorisé pour le format du document, et tous les documents du même format encore en attente sont ré-arbitrés sur-le-champ — 197 documents par verdict en médiane, mesuré en production. C’est ainsi que le taux de documents validés est passé de 63 % à froid à 99,3 % sur 195 000 documents : quelques dizaines de corrections humaines, des milliers de documents appris.
La correction d’un exploitant fait autorité : elle est mémorisée, horodatée, et une valeur réfutée ne revient jamais en validation automatique.
Les documents du même émetteur encore en file sont revalidés d’un coup. Le 1er septembre 2026, onze verdicts ont validé 1 022 documents.
Des contre-expertises automatiques tournent en permanence, et 1,5 % des documents validés automatiquement sont resservis à une personne en audit aléatoire.
Gardez votre TMS. On automatise ce qui rentre dedans.
Changer de TMS pour obtenir de la lecture automatique de documents, c’est un projet de migration pour résoudre un problème de saisie. Le moteur AIR.TEK est une couche d’intelligence qui s’ajoute à votre système actuel, quel qu’il soit : API REST, webhooks, dépôt SFTP ou dossier partagé, boîte e-mail surveillée, exports CSV et JSON. La correspondance avec vos champs est réglée pendant la mise en place, et rien n’est écrit dans le TMS sans être passé par le contrôle.
Saisie automatique dans votre TMS : le détail →
Votre volume double ? Votre facture ne double pas.
Le marché de la lecture de documents se facture à la page, au crédit ou au compteur : le coût suit votre activité, et le compteur repart à zéro chaque année. Le moteur AIR.TEK est installé chez vous et se licencie à l’année. Le millionième document coûte la même chose que le premier : rien.
* dans la capacité de votre serveur — la seule limite est physique, pas contractuelle.
Le moteur tourne sur un serveur dans vos locaux. Bons de livraison, CMR, tarifs négociés, clients : rien n’est envoyé à un service d’IA distant. Fonctionne même sans Internet.
Une licence annuelle, un volume illimité dans la capacité de votre serveur. À plusieurs milliers de documents par jour, le coût est connu d’avance — il ne grimpe pas avec votre activité.
Vos validations nourrissent le modèle installé chez vous. Il devient meilleur sur vos fournisseurs, vos sites, vos habitudes — et ce progrès vous reste.
Le serveur installé chez vous (SABER) → IA locale en entreprise →
Moteur transport, OCR générique ou TMS à changer.
| OCR générique en ligne | IA intégrée à un nouveau TMS | Moteur transport AIR.TEK | |
|---|---|---|---|
| Entraîné sur des documents transport | Non, modèles génériques | Parfois, sur les formats de l’éditeur | Oui — mesuré sur 195 000 BL réels, 2 365 formats |
| Types de documents | Quelques familles prédéfinies | Ceux de l’éditeur | 36 types en 14 familles ; extraction complète sur BL, affinage sur vos autres types |
| Adapté à vos documents | Gabarits à configurer | Selon l’éditeur | Affiné sur vos formats pendant le pilote |
| Nouveau fournisseur, format inconnu | Nouveau gabarit à créer | Selon l’éditeur | Lu sans configuration ; validé s’il y a doute |
| Où vont vos documents | Cloud du fournisseur | Cloud de l’éditeur | Sur votre serveur, chez vous |
| Votre TMS | Vous le gardez | Vous changez de TMS | Vous le gardez |
| Coût à volume élevé | À la page ou au crédit — grimpe avec le volume | Inclus dans un contrat TMS | Licence annuelle, volume illimité dans la capacité du serveur |
| Précision | Annoncée, rarement détaillée par champ | Annoncée | 99,3 % de documents validés ; exactitude par champ publiée |
| Débit | Selon le forfait et les quotas d’API | Selon l’éditeur | Jusqu’à 10 000 documents / heure (déploiement de base, mesuré) |
Et face à ChatGPT sur des documents ? Le comparatif →
Personnes, heures par semaine, profil : le calculateur donne les heures consommées par mois et la capacité représentée. Rien n’est enregistré.
OCR transport : vos questions.
Que valent vos chiffres exactement ?
Ils viennent de la production réelle chez un client : 195 514 bons de livraison traités, 99,3 % validés — 97,9 % sans aucune intervention humaine, 1,4 % validés en lot après quelques corrections qui ont appris leur format au système, et ce taux monte avec l’usage. Contre une vérité humaine, sur les documents validés automatiquement, l’émetteur est juste à 99,4 %, la date à 98,9 %, le numéro à 94,4 %. Sur des émetteurs jamais vus, le numéro est lu à 96,4 % et la date à 97,2 % avant toute résolution. Un document abîmé est traité quand même — 100 % des documents sont pris en charge — et ses champs incertains sont signalés, jamais inventés. La méthode complète est sur la page benchmark.
Quelle vitesse de traitement ?
10 216 documents par heure en moyenne sur une campagne complète, 7 788 en régime établi, mesurés sur le déploiement de base installé chez un client — un serveur, une carte graphique de classe serveur. Le débit réel sur vos documents et votre serveur est mesuré pendant le pilote.
Lisez-vous les documents manuscrits, abîmés ou en langue étrangère ?
Oui, et ils font partie du flux réel mesuré : scans dégradés ou penchés, annotations manuscrites (3 899 documents signalés par le détecteur), lettres de voiture internationales en langue étrangère (1 475). Tous sont traités — aucun document n’est rejeté. Dans tous les cas, quand la lecture est incertaine, le champ est surligné et une personne valide : l’IA ne devine jamais en silence.
Quels types de documents reconnaissez-vous ?
Trente-six types de documents transport, regroupés en quatorze familles, identifiés sur plus de 3 500 pages réelles : bon de livraison, lettre de voiture nationale et internationale (CMR), bon de transport, confirmation de transport, ordre de transport, bon de commande, confirmation de commande, bon de préparation, bon d’expédition, fiche palette, liste de chargement, bon d’enlèvement, bon de prise en charge, facture, bon de retour, et leurs variantes en espagnol et en italien. Sur chacun, le moteur extrait d’emblée le type, le numéro, la date et l’émetteur. L’extraction complète — destinataire, contenu ligne à ligne — est entraînée sur le bon de livraison et s’étend à vos autres types par affinage.
Pouvez-vous traiter un document propre à mon entreprise ?
Oui. Le modèle s’affine sur n’importe quel type de document à partir de vos exemplaires : on définit ensemble les champs à extraire, on mesure sur un échantillon pendant le pilote, puis on met en production avec validation humaine des cas incertains.
Et si un fournisseur envoie un format qu’on n’a jamais vu ?
Le moteur ne fonctionne pas par gabarit. Sur 1 000 documents de 127 émetteurs jamais vus à l’apprentissage, il lit le numéro à 96,4 % et la date à 97,2 % en lecture seule. Les premiers exemplaires d’un émetteur inconnu sont validés avec réserve ou par vos équipes, et chaque validation mémorise le format pour les suivants.
Dois-je changer de TMS ou d’ERP ?
Non. Le moteur s’ajoute à ce que vous avez : API, webhooks, dépôt SFTP ou dossier, boîte e-mail surveillée, exports CSV/JSON. La correspondance avec les champs de votre TMS est faite pendant la mise en place.
Mes documents quittent-ils l’entreprise ?
Non. Le moteur est installé sur un serveur dans vos locaux. Les documents, les extractions et le modèle restent chez vous ; aucun envoi vers un service d’IA distant.
Comment est-ce facturé ?
Par une licence annuelle avec un volume illimité, dans la capacité de votre serveur — pas à la page ni au crédit. À plusieurs milliers de documents par jour, c’est ce qui rend le coût prévisible. Le montant est chiffré après un premier échange gratuit de 30 minutes, selon le périmètre et le serveur.
Que couvre exactement la licence ?
Une entité juridique, un environnement de production, pour vos besoins internes — avec un nombre de documents et d’utilisateurs illimité dans la capacité du serveur. Un site ou une filiale supplémentaire, un second serveur de production, une famille de documents supplémentaire ou un niveau de service renforcé font l’objet d’une extension, chiffrée à part.
Combien de temps pour démarrer ?
Quelques semaines pour un premier flux : installation du serveur, branchement du canal d’entrée et du TMS, pilote mesuré sur vos documents, puis mise en production avec validation humaine des cas incertains.
Peut-on tester sur nos propres documents avant de décider ?
Oui, c’est même la règle : on mesure la précision sur un échantillon de vos documents réels pendant le pilote, champ par champ, avant tout engagement.